string是什么意思(String(字符串):一切方法都在掌握之中)【String - 字符串】 什么叫学习?那就是学别人的东西。像我这样- 什么叫好好学习?那就是把别人的的东西学好。像我这样- 好好学习,天天向上。像我这样- 不错,上面都是扯淡,下面要说的东西是才是认真的。 在JavaScript代码中,一种出现频率特别高的数据类型,几乎每一次代码中,我们都需要通过使用一些方式方法去处理它,从而得到我们想要的结果,这些方式方法,各种各样,各自有各自的特点和用法,在这里,不管是复习还是学习,小郑给大家总结一下,ECMAScript中所有关于字符串的处理方式。 重要说明:为了让了手速度能跟上思维,大部分举例我都会通过chrome控制台完成。有不适应者,请适应。 一、关于字符串分割1、slice 语法:slice(start,end) 关于这个方法,一定要搞懂四个关键点: (1)截取字符串时不包括下标为end的元素。 (2)end是可选参数,没有时,默认从start到结束的所有字符串。 (3)String.slice与Array.slice区别。 (4)参数为负数时,是如何处理的。 其中第3点其实就是在JavaScript中字符串和数组都具有这个方法,它们的返回结果形式不一样,一个是一段字符串,一个是一段浅复制后的数组。另外三个点接着往下看你就会明白。 2、substr 语法:substr(start,length) 关于这个方法,也需要搞懂几个关键点: (1)第二个参数是子串中的字符数,必须是数值。可以没有。 (2)参数为负数时如何进行处理。 (3)最重要一点来自官网说明,如下所示: 
由于substr() 的参数指定的是子串的开始位置和长度,因此它可以替代 substring() 和 slice() 来使用。 3、substring 语法:substring(start,stop) 关于这个方法,同样需要搞懂几个关键点: (1)返回的字符串中不包括 stop 处的字符。 (2)参数为负数时如何进行处理。 (3)如果参数 start 与 stop 相等,那么该方法返回的就是一个空串(即长度为 0 的字符串)。 (4)如果 start 比 stop 大,那么该方法在提取子串之前会先交换这两个参数。 这个方法的作用同样可以使用slice方法来替代。 在讲第四个方法之前,先来捋一捋上面这三个方法的区别和使用: (一):都接收两个参数,slice和substring接收的是起始位置和结束位置(注意:不包括结束位置),而substr接收的则是起始位置和所要返回的字符串长度。 我想,下面这个例子足够说明这一点: 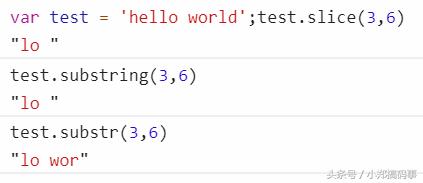
看一下控制台运行出来的结果,其中slice/substring都是从0开始截取3到6位置但不包括6位置的字符串"lo ",对比之下,substr截取3位置之后的6个字符串"lo wor"。 (二):需要注意substring是以两个参数中较小一个作为起始位置,较大的参数作为结束位置。 来,在控制台验证一下: 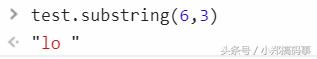
上面这个(6,3)会默认变成(3,6)将小的当起始位置来处理。 接下来第三点很关键,一定要记清楚,虽然不常用,但用了就很容易出BUG。 (三):参数为负数时如何解析。 (我认为这种负数的情况就应该在标准中禁止掉,参数中有负数时直接报错就行,可现在竟然能为负数,那我们只有两条出路:1,避免在code的时候出现它;2,就是今天我们要做的,彻底搞懂它。一次性消灭掉) slice:将字符串的长度与对应的负数相加,结果作为参数。 substr:只会将第一个参数与字符串长度相加后的结果作为第一个参数(第一个参数为负数)。 substring:直接将负参数直接转成0。 下面我来举个例子,因为有一个参数和两个参数的情况,所以,我得分别举两种情况的例子,把这个问题讲明白。 第一,先看一个参数的情况: 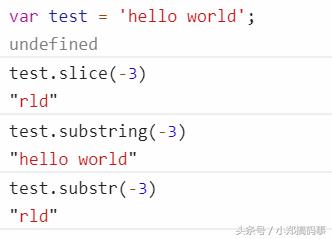
解释一下上面的结果:字符串长度是11,(11-3=8),所以slice(-3)和substr(-3)从下标为8的字母开始。得到的结果就是"rld"。而substring直接将负数据转为0,所以输出结果就是"hello world"。 第二,看一下两个参数的情况: 先回忆一下上面的定义: slice:长度与负数相加作为参数。 substring:负数直接转为0。 substr:仅将第一个参数与长度相加作为第一个参数。 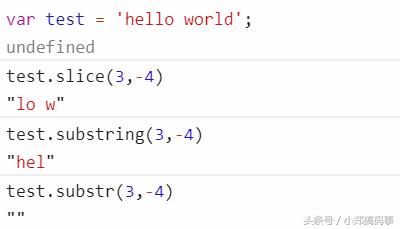
解释一下输出的结果:slice(3,11-4)就是从下标3截取到下标7的字符串,这里就是"lo w"。substring(3,0),其中-4直接转成0,所以由定义从下标0截取到3,这里表示"hel"。最后一个substr第一个参数不是负数,第二个表示长度的参数为负数时,输出只能是空字符串。 4、split 语法:split(separator,howmany) 这个方法作用就是将一个字符串分割成字符串数组。 需要记住两个地方: 1、separator可以是字符串或正则表达式。 2、howmany可选参数,表示返回数组的最大长度。 举两个例子: 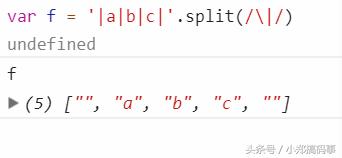
上面separator是正则表达式的情况。 再来看一个拥有howmany参数的情况。 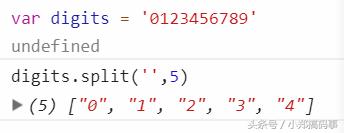
来阐述一下。split方法把一个字符串string分割成片段创建一个字符串数组,可选参数howmany可以限制被分割的片段的数量。separator参数可以是一个字符串或一个正则表达式。 二、其它字符串处理方法1、charAt(pos) 返回指定位置(如上pos)的字符。如果pos小于0或者大于等于字符串的长度string.length,它会返回空字符串。 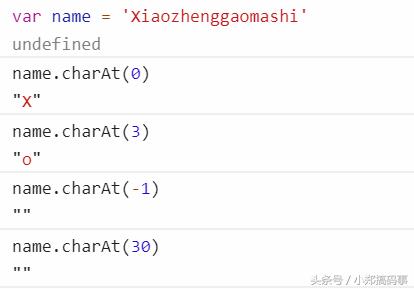
charAt其实可以像下面这样实现: 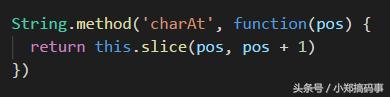
2、charCodeAt(pos) 和上面那个方法类似,只是它返回指定位置的字符的 Unicode 编码。这个返回值是 0 - 65535 之间的整数。 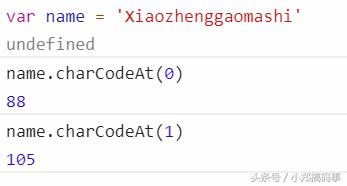
3、concat(string...) 用于连接两个或者多个字符串。相较于数组Array.concat()。其实字符串到是用的不多,主要是之前使用加号(+)会更方便一些,新语法时一步优化字符串拼接的操作。 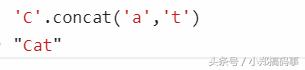
4、indexOf(searchString,position) 在string内查找另一个字符串searchString。如果它被找到,就返回第1个匹配字符的位置,否则返回-1。 需要记住一点是:可选参数position可设置从string的某个指定的位置开始查找。 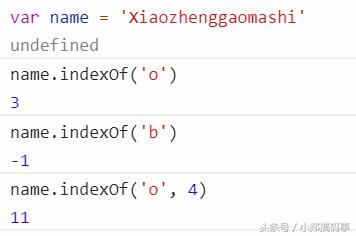
上面最后一个输出,设置position=4,让它从第4个位置开始查找,所以查到第二次出现O的位置是11 。 5、lastIndexOf(searchString,position) 与indexOf方法类似,只不过它是从该字符串的末尾开始查找而不是从开头。 总结就是,查找的方向是反的,顺序是正的。如下代码: 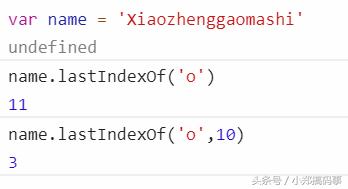
6、localeCompare(that) 据官方给出的语法格式是:stringObject.localeCompare(target),那么我们就从这个格式开始分析它的作用。 用来比较两个字符串,返回比较结果数字。如果stringObject 小于 target,则 localeCompare() 返回小于 0 的数。如果 stringObject 大于 target,则该方法返回大于 0 的数。如果两个字符串相等,或根据本地排序规则没有区别,该方法返回 0。 所以,其实这个方法可以用比较中文是否相同,下面我举三段代码来看一下结果: 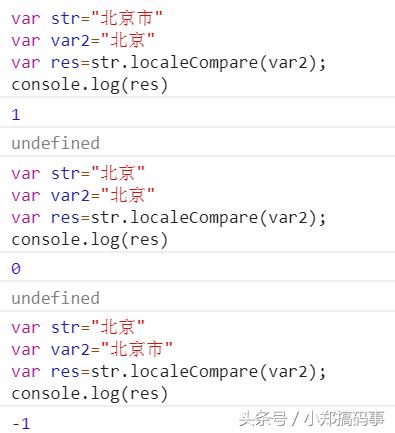
7、match(regexp) match方法让字符串和一个正则表达式进行匹配。它依据g标识来决定如何进行匹配。如果没有g标识,那么调用string.match(regexp)的结果与调用regexp.exec(string)的结果相同。带g标识返回的是一个结果数组,具体如下代码所示: 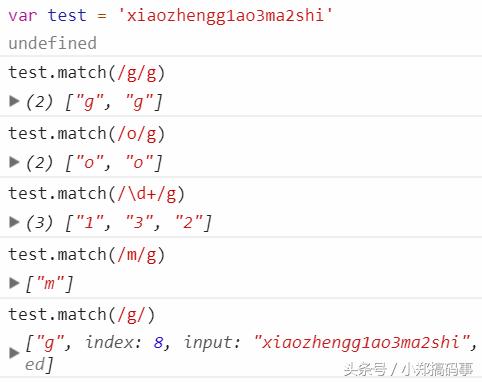
8、replace(searchValue,replaceValue) 作用:replace方法对string进行查找和替换操作,并返回一个新的字符串。 取值:而参数searchValue可以是一个字符串或者一个正则表达式对象。 第一种情况:如果searchValue是一个字符串,那么searchValue只会在第1次出现 的地方被替换。 【举个例子】: 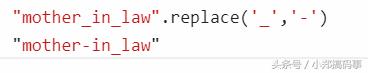
上面这例子就证明searchValue是一个字符串时,只会在第1次出现的地方被替换。 第二种情况:如果searchValue是一个正则表达式并且带有g标识,它会替换所有的匹配。如果没有带g标识,它会仅替换第1个匹配。 【举个例子】: 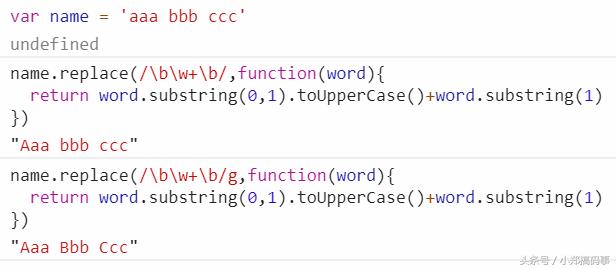
这个例子很简单,为的是说明searchValue为正则表达式时带g与不带g的情况。我先来简单解释一下上面这段代码: 首先,定义了一个name具有三段字符的字符串。 其次,serchValue定义了一个正则表达式,其意义是: \b:匹配单词边界,准确的说是表达独立部分,可以是起始,结束,空格。 \w+:表示多个字符组合( 字母 ,数字,下划线_ )。 最后,如果不加g的话,如上,只匹配第一串字符。加了之后所有的都匹配了。 第三种情况:replaceValue可以是一个字符串或一个函数,如果replaceValue是一个字符串,字符$拥有特殊的含义。 关于replaceValue是函数的情况,上面已经有一个例子了,但是等会我还会举一个经典例子来分析一下。 现在我们来看一下是字符串的情况下,$的特殊含义。先来看一个例子的结果,然后我再来解释一下每行代码的意义。 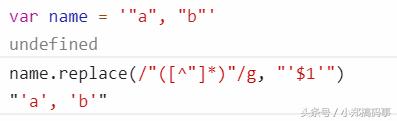
这个正则表达式也很简单,不过需要注意的一个地方是:/[^"] / 和 /^["]/是不一样的,前者是排除的意思,后者是代表首位。(有关正则表达式部分也没有什么难的,而且有一些在线的工具可以利用,下回我用一篇专门来写一下如何搞。) 其次就是讲一下$number-表示分组捕获的文本,即与regexp中的第number个子表达式相匹配的文本,后面这一句话比较是关键。上面那个例子$1就代表前面searchValue正则所匹配的每一项内容。 然而,这个时候关于$0,$1,$2等等,可能还不是很清楚,那么,我决定,再举一个更详细的例子来给大家讲一下。如下所示: 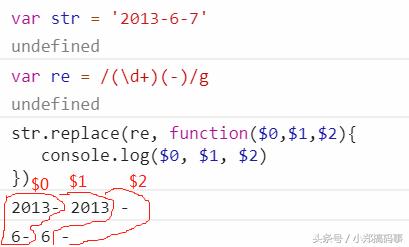
这个例子是不是可以直接将2013-6-7变成2013.6.7了,对的,直接在函数里面return $1+‘.’。 $0:匹配成功后的整体结果(2013-,6-)。 $1:匹配成功后的第一个分组,这个例子中指的是\d(2013,6)。 $2:匹配成功后的第二个分组,这个例子中指的是-(- -)。 这样一搞,是不是就清晰多了?。好吧,不常用,用好也不容易,用好了才能才知道它有什么用,balabalabalabalabala。有关replace就说到这里。 9、search(regexp) 这个方法,老夫工作五年都没用过,但这并不能说它就没有用,更不能识而不见,竟然意外相见,那就认识一下。 search方法其实和indexOf方法有点类似。这句话一定要理解。 返回:它只接受一个正则表达式对象作为参数而不是一个字符串。如果找到匹配,它返回第1个匹配的音字符位置,如果没有找到匹配,则返回-1。这个方法会忽略g标识,且没有position参数。 这个表述已经很精简了,免去了你看官网那一堆balabala的文字所要花的时间。下面就来举个例子: 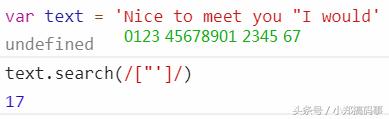
上代码输出"的位置:17。绿色部分用来标识位置信息,当在10及以上时省略第一位显示。这样看是不是有点类似于indexOf的返回。 明白了吗?少年,搞懂了,我们就要来搞字符串中一堆大小写转换的方法。 10、大小写转换 ECMAScript中涉及到字符串大小写转换的方法总共有4个。 (1)toLowerCase() (2)toLocaleLowerCase() (3)toUpperCase() (4)toLocaleUpperCase() 1和3比较经典,2和4是针对特定地区的实现。 对有些地区来说,针对地区的方法与其通用方法得到的结果相同,但少数语言(如土耳其语言)会为Unicode大小写转换应用特殊的规则,这时候就必须使用针对地区的方法来保证实现正确的转换。 看一个例子: 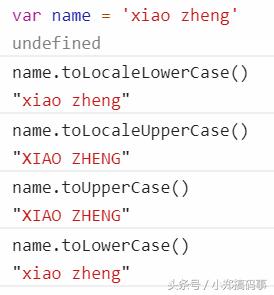
针对地区的方法和通用的方法输出结果是一样的,大部分情况都会这样,还是建议在不知道自己的代码将在那种语言环境中运行的情况下,还是使用针对地区的方法更稳妥一些。 11、fromCharCode(char...) 用w3c上的定义,可接受一个指定的Unicode值,然后返回一个字符串。 举个例子吧: 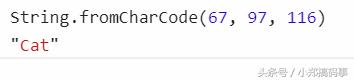
以上这些,就是我能想到的ECMAScript中用来处理处理字符串的方式方法。如还有其它,欢迎留言,我再补上。下面我来针对全文的内容做一个总结。 |