以下内容来自 刘建平 Pinard-博客园的学习笔记,总结如下: 深度神经网络(Deep Neural Networks, 以下简称DNN)是深度学习的基础,而要理解DNN,首先我们要理解DNN模型,下面我们就对DNN的模型与前向传播算法做一个总结。 apple-system, BlinkMacSystemFont, "Helvetica Neue", "PingFang SC", "Microsoft YaHei", "Source Han Sans SC", "Noto Sans CJK SC", "WenQuanYi Micro Hei", sans-serif; clear: left; color: rgb(26, 26, 26);"> 1 从感知机到神经网络感知机的模型,它是一个有若干输入和一个输出的模型,如下图: 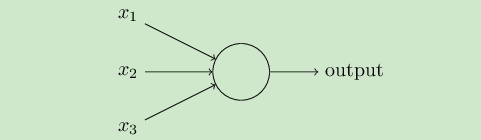 输出和输入之间学习到一个线性关系,得到中间输出结果: 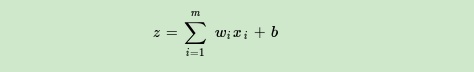 接着是一个神经元激活函数: 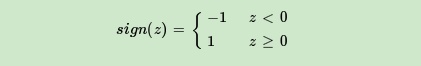 从而得到想要的结果1或者-1. 这个模型只能用于二元分类,且无法学习比较复杂的非线性模型,因此在工业界无法使用。而神经网络则在感知机的模型上做了扩展,总结下主要有三点: (1) 加入了隐藏层 ,隐藏层可以有多层,增强模型的表达能力,如下图实例,当然增加了这么多隐藏层模型的复杂度也增加了好多。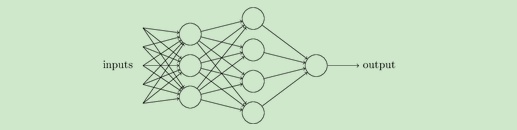 (2) 输出层的神经元也可以不止一个输出,可以有多个输出 ,这样模型可以灵活的应用于分类回归,以及其他的机器学习领域比如降维和聚类等。多个神经元输出的输出层对应的一个实例如下图,输出层现在有4个神经元了。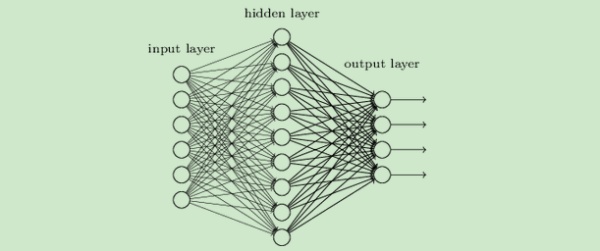
(3)对激活函数做扩展,感知机的激活函数是
层与层之间是全连接的,也就是说,第i层的任意一个神经元一定与第i+1层的任意一个神经元相连。虽然DNN看起来很复杂,但是从小的局部模型来说,还是和感知机一样,即一个线性关系
再看偏倚b的定义。 还是以这个三层的DNN为例,第二层的第三个神经元对应的偏倚定义为
3 DNN前向传播算法数学原理
假设选择的激活函数是
从上面可以看出,使用代数法一个个的表示输出比较复杂,而如果使用矩阵法则比较的简洁。假设第l−1层共有m个神经元,而第l层共有n个神经元,则第l层的线性系数w组成了一个n×m的矩阵 4 DNN前向传播算法所谓的DNN前向传播算法就是利用若干个权重系数矩阵W,偏倚向量b来和输入值向量x进行一系列线性运算和激活运算,从输入层开始,一层层的向后计算,一直到运算到输出层,得到输出结果为值。 输入: 总层数L,所有隐藏层和输出层对应的矩阵W,偏倚向量b,输入值向量x 输出:输出层的输出。 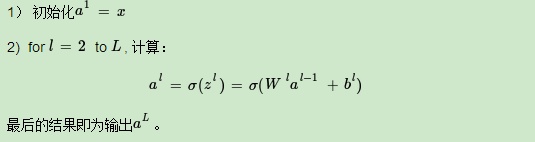 5 DNN反向传播算法要解决的问题
假设我们有m个训练样本 损失函数有了,用梯度下降法迭代求解每一层的w,b。
首先是输出层第 对于输出层的参数,损失函数变为: 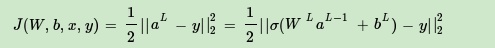 求解W,b的梯度: 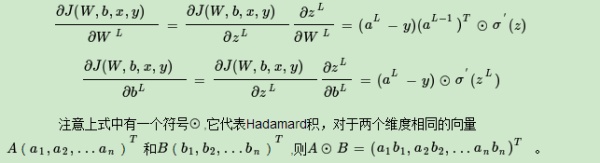 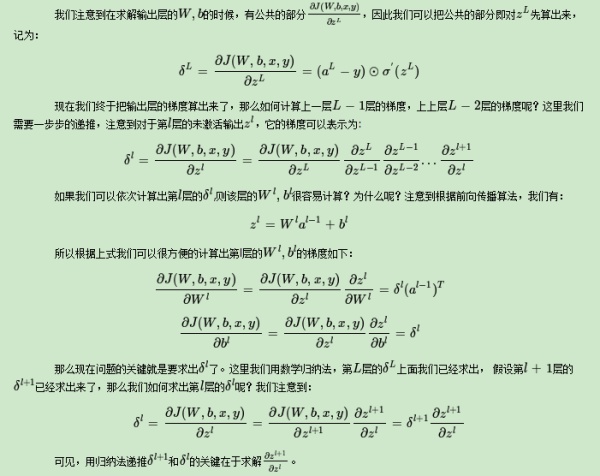 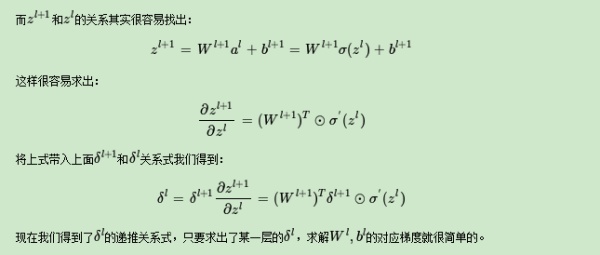 7 DNN反向传播算法过程由于梯度下降法有批量(Batch),小批量(mini-Batch),随机三个变种,为了简化描述,这里我们以最基本的批量梯度下降法为例来描述反向传播算法。实际上在业界使用最多的是mini-Batch的梯度下降法。区别仅仅在于迭代时训练样本的选择。
输入:总层数 8 均方差损失函数+Sigmoid激活函数的问题在讲反向传播算法时,我们用均方差损失函数和Sigmoid激活函数做了实例,首先我们就来看看均方差+Sigmoid的组合有什么问题。 首先我们回顾下Sigmoid激活函数的表达式为:
从上图可以看出,对于Sigmoid,当z的取值越来越大后,函数曲线变得越来越平缓,意味着此时的导数
在均方差+Sigmoid的反向传播算法中,每一层向前递推都要乘以 W,b更新到极值的速度较慢,也就是我们的算法收敛速度较慢。那么有什么什么办法可以改进呢? 9 交叉熵损失函数+Sigmoid激活函数改进DNN算法收敛速度 |


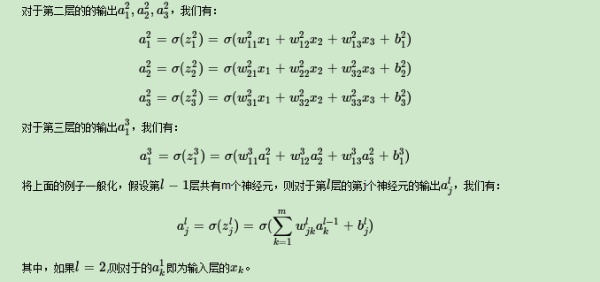


 也越来越小。同样的,当z的取值越来越小时,也有这个问题。仅仅在z取值为0附近时,导数


